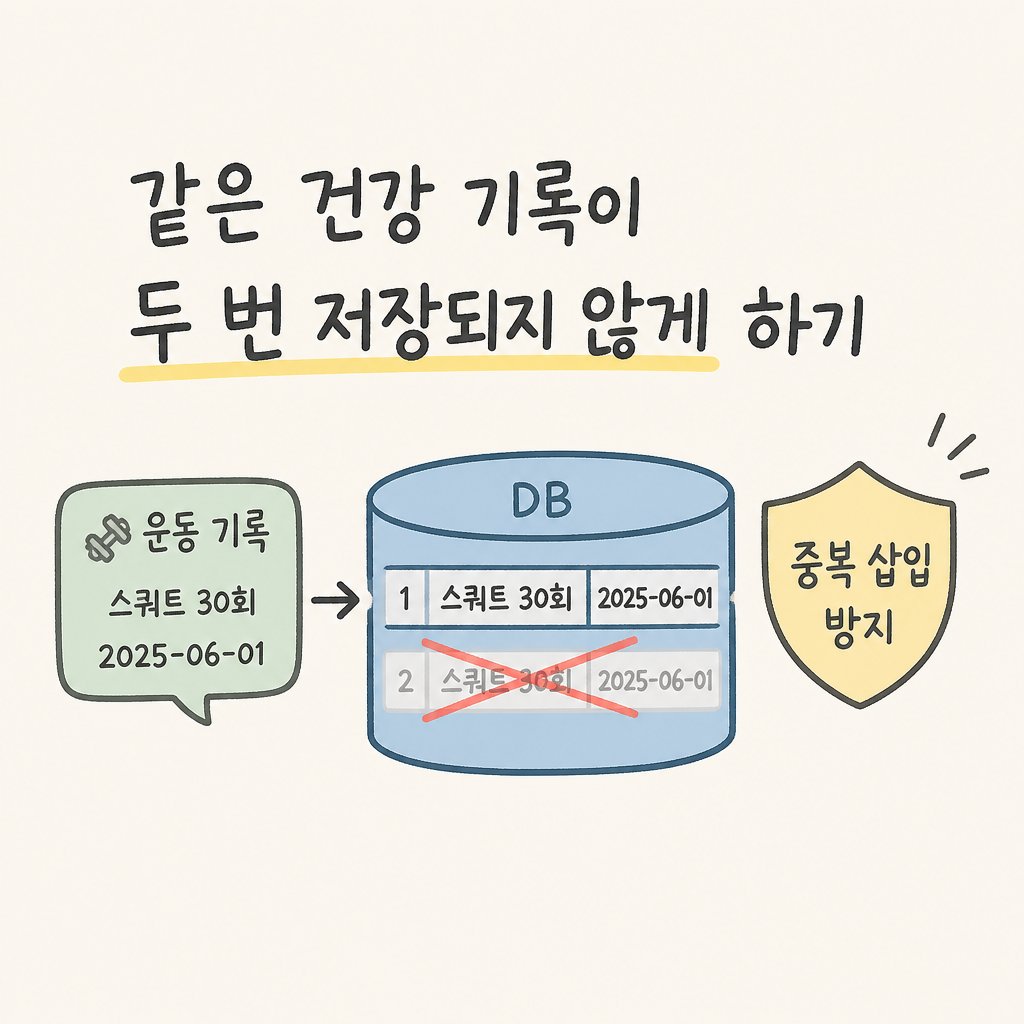
Teddy의 Personal Trainer Agent는 Slack에서 운동, 식단, 체중 같은 건강 기록을 받고 SQLite에 저장하는 구조로 시작했습니다. 기록을 모은 뒤 최근 기록이나 리포트를 반환하는 흐름입니다. 처음에는 꽤 단순해 보였습니다.
그런데 저장 기능을 붙이고 나니, 다른 문제가 보이기 시작했습니다. 같은 입력이 반복해서 들어오거나 처리 과정이 다시 실행되면 하나의 건강 기록이 여러 레코드로 쌓일 수 있었습니다.
운동을 두 번 한 것도 아니고, 식단을 두 번 기록한 것도 아닌데 데이터만 두 줄이 되는 상황이죠. 나중에 기록을 조회하거나 리포트를 만들 때 실제로 한 번 있었던 일이 두 번 있었던 것처럼 보일 수 있습니다. 기록을 모으는 에이전트라면 꽤 곤란한 문제입니다.
처음에는 운동·식단·체중 기록을 받아 데이터베이스에 남기는 기본 흐름부터 만들었습니다. 그 다음에 중복 health record insert를 막는 수정이 별도로 들어갔습니다.
핵심은 화면에서 같은 기록을 한 번만 보여주는 게 아니었습니다. 저장하는 단계에서부터 같은 사건이 여러 번 삽입되지 않도록 막아야 했습니다. 그래야 이후에 최근 기록을 읽거나 주간 리포트를 계산할 때도 데이터의 의미가 흔들리지 않습니다.
그래서 Teddy의 health record 저장 과정에 duplicate insert 방지 로직을 적용했습니다. 반복 입력이나 재처리 가능성을 저장 흐름 자체에서 고려하도록 바꾼 것입니다. 실제로 중복이 몇 번 발생했는지, 수정 전후에 어떤 수치 차이가 있었는지는 저장소 기록만으로 확인할 수 없어서 여기서 더 크게 말하기는 어렵습니다.
이 수정은 새로운 분석 기능을 추가한 작업은 아닙니다. 운동 기록을 더 똑똑하게 해석하거나, 식단에 더 정교한 피드백을 주는 일도 아니고요. 그보다 먼저, 기록을 기록답게 남기는 쪽에 가깝습니다.
이런 문제는 기능을 만들 때는 잘 보이지 않습니다. 입력이 들어오고 저장이 되면 일단 성공처럼 보이니까요. 하지만 에이전트가 같은 일을 다시 처리할 수 있다는 조건을 넣는 순간, ‘저장됐다’와 ‘정확히 한 번 저장됐다’는 다른 말이 됩니다.
현재 Teddy 건강 기록 저장에는 중복 삽입을 막는 보완이 반영되어 있습니다. 다만 저장이 안전해졌다고 해서 그 기록이 이후 coaching 단계에서 자동으로 잘 활용된다는 뜻은 아닙니다. 기록을 보관하는 경로와 다시 읽어오는 경로는 별개의 문제니까요.
다음에는 저장된 health scout context가 실제 coaching 단계에서 다시 조회되지 않았던 문제를 다룹니다. 저장만 해두면 에이전트가 기억할 거라고 생각하기 쉽지만, 현실은 조금 더 귀찮습니다.