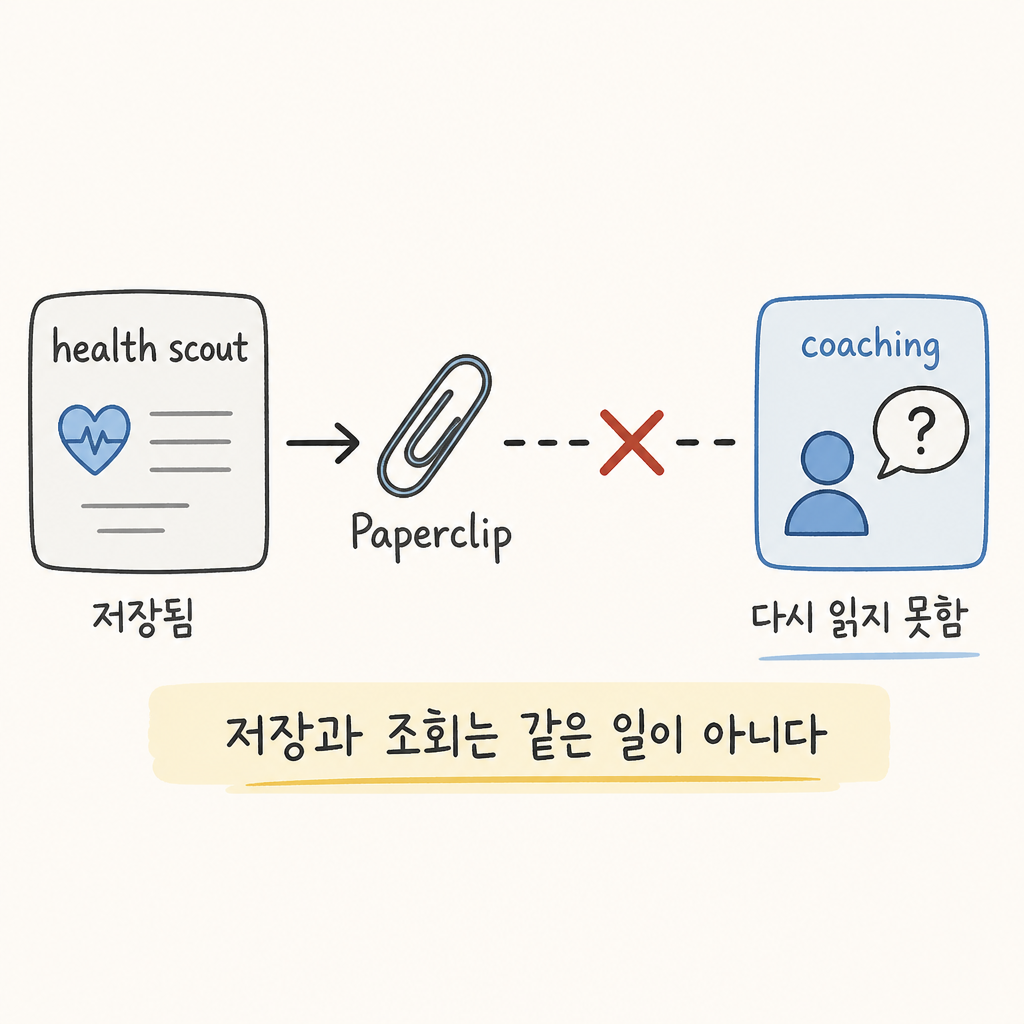
Teddy의 health scout 결과를 Paperclip에 남기는 기능이 먼저 추가됐고, 이제 coaching 단계에서 그 내용을 참고하면 된다고 생각하기 쉬운 구조였어요.
그런데 저장과 조회는 같은 일이 아니었습니다.
health scout가 Paperclip에 저장됐다는 사실만으로는 coaching이 그 내용을 자동으로 기억하지 못했습니다. 저장하는 경로는 있었지만, 실제 coaching 단계에서 필요한 health scout context를 다시 읽어오는 연결부가 제대로 맞물리지 않았던 거예요. 데이터가 사라진 문제가 아니라, 저장된 곳과 사용하는 곳 사이의 경로가 끊긴 문제에 가까웠습니다.
이 차이는 중요했습니다. 구현상 기록을 남기는 것과 기록을 coaching 입력으로 받는 것은 다른 단계이기 때문입니다. Paperclip에 데이터가 존재하는지와 Teddy가 그 데이터를 coaching에 사용할 수 있는지는 별도로 확인해야 했습니다.
처음 추가된 것은 Teddy health scout를 Paperclip에 저장하는 기능이었습니다. 이 단계만 보면 흐름은 간단합니다.
health scout 생성 → Paperclip 저장 → coaching에서 활용
하지만 실제 구현에서는 가운데 저장 단계가 끝났다고 마지막 단계까지 이어지는 것은 아니었습니다. 여기서 저장 기능과 retrieval 기능이 서로 다른 문제라는 점이 드러났습니다.
그래서 이후에는 Teddy의 Paperclip health scout retrieval 로직을 따로 수정했습니다. 저장 기능을 다시 만드는 방향이 아니라, 이미 저장된 context를 coaching 단계가 실제로 조회하도록 읽기 경로를 보완한 것입니다.
이 수정 이후 Teddy 쪽에는 health scout를 Paperclip에 남기는 흐름과, 그 기록을 coaching에서 다시 가져오는 흐름이 분리되어 정리됐습니다. 물론 이것만으로 coaching 결과의 품질이나 운영 성능이 모두 해결됐다고 말할 수는 없습니다. 다만 적어도 “저장됐으니 에이전트가 알고 있겠지”라고 넘기지 않고, 저장과 조회를 각각 확인해야 한다는 경계는 분명해졌습니다.
개인 프로젝트를 만들다 보면 기능 하나를 추가한 뒤 이름이 비슷한 다음 기능까지 자연스럽게 이어졌다고 착각하기 쉽습니다. 특히 메모리나 context라는 말을 붙이면 더 그렇습니다. 하지만 실제로는 쓰기와 읽기, 보관과 사용 사이에 각각 다른 코드와 조건이 필요합니다. 저장만 해놓고 기억한다고 부르면 조금 곤란합니다. 데이터베이스는 거짓말을 하지 않지만, 에이전트가 읽었다는 뜻도 아니니까요.
이번 수정으로 Teddy의 health scout 저장·조회 연결부는 보완됐습니다. 다음에는 데이터가 잘 이어지는지와는 조금 다른 문제를 보게 됩니다. 프로세스가 정상 종료됐다는 이유만으로, 그 출력까지 정상적인 모델 응답이라고 믿어도 되는지는 별도로 확인해야 했습니다.